
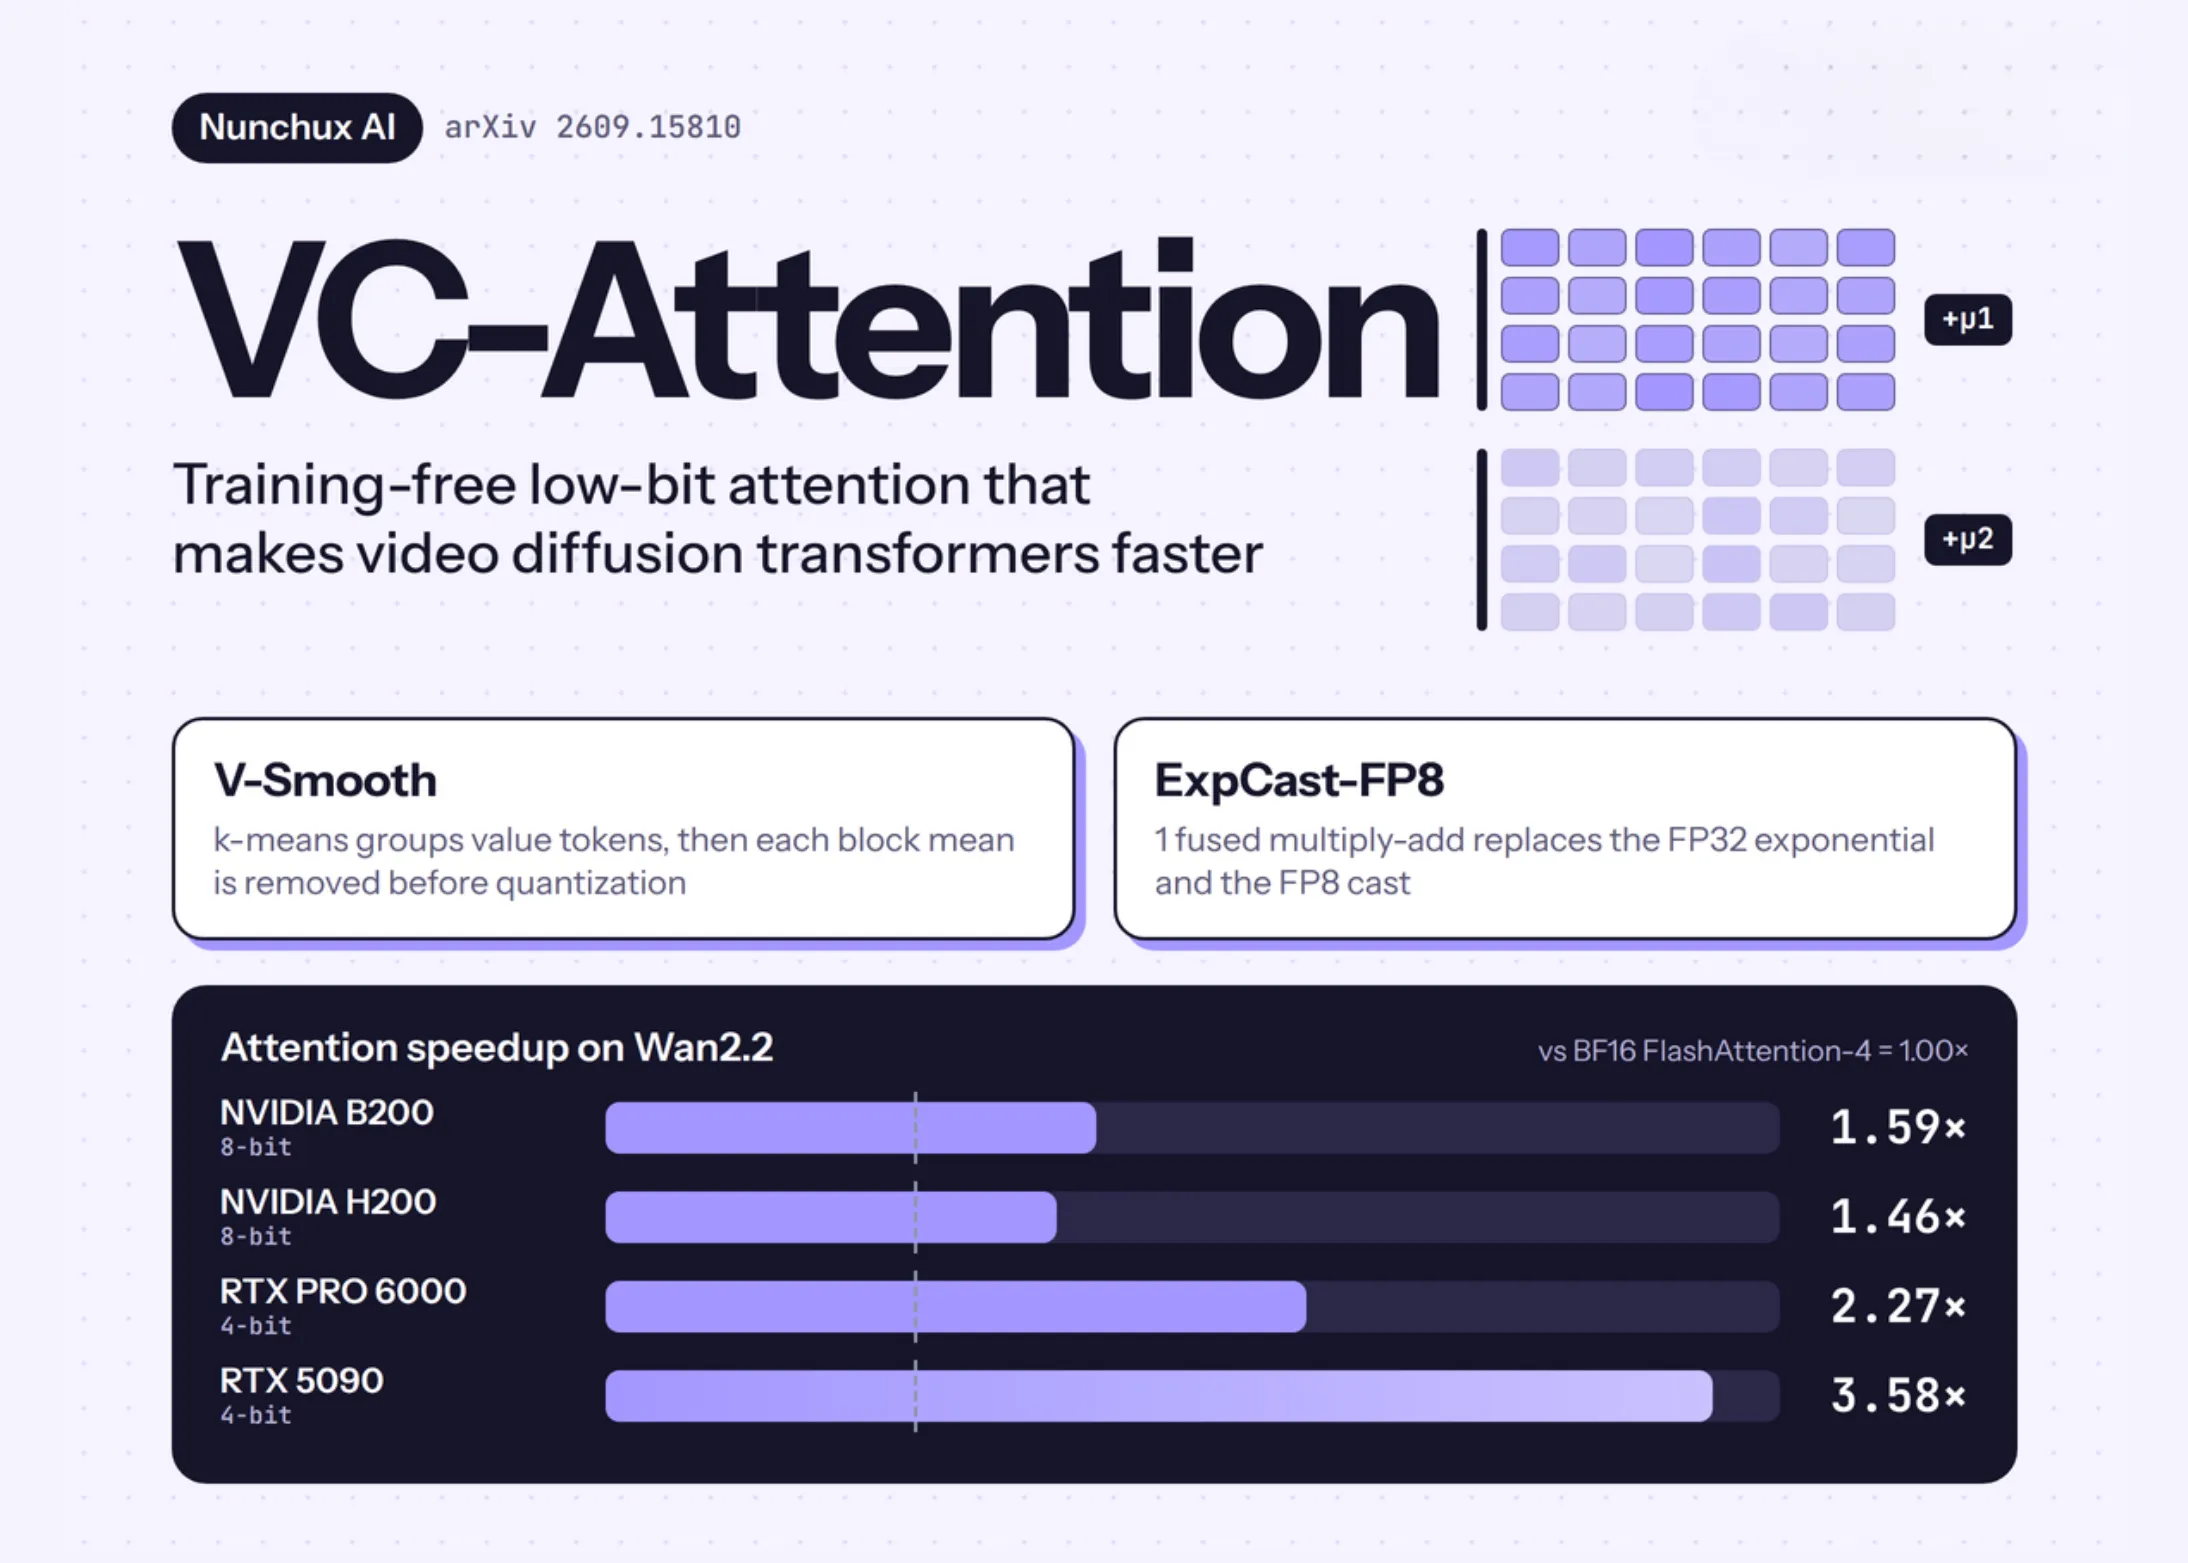
Nunchux AI VC-Attention প্রকাশ করেছে, ভিডিও ডিসপারসন ট্রান্সফরমার (DiTs) এর জন্য নির্মিত একটি অপ্রশিক্ষিত লো-বিট মনোযোগ কার্নেল। এটি একই সময়ে 2টি সমস্যাকে লক্ষ্য করে: মান পরিমাপকরণ ত্রুটি এবং ধীর সফটম্যাক্স পদক্ষেপ।
কেন মনোযোগ ভিডিওর বাধা
ভিডিও ডিআইটি একটি ক্লিপকে স্প্যাটিও-টেম্পোরাল টোকেনগুলির একটি একক ক্রমে সমতল করে এবং প্রতিটি স্তরে সম্পূর্ণ স্ব-মনোযোগ প্রয়োগ করে। একটি 5 সেকেন্ডের 720p Wan2.2-14B ক্লিপ প্রায় 70K টোকেন বিস্তৃত করে৷ RTX 5090-এ, মনোযোগ সৃষ্টির সময়ের 64% এর বেশি লাগে। গবেষণা দল বলে যে মনোযোগ প্রতিটি মিনি-ম্যাক্স-এইচ3 ডি-নোজ স্টেজের প্রায় দুই-তৃতীয়াংশ একক B200-এ।
লো-বিট টেনসর কোর 2টি ম্যাট্রিক্স পণ্য, QK এবং PV ত্বরান্বিত করে। ২টি বাধা রয়ে গেছে। প্রথমত, আগের পদ্ধতি যেমন SageAttention2 শেয়ার করা প্রশ্ন এবং কী। QK মসৃণকরণ এবং ঘূর্ণনের পরে, Wan2.2-এর আউটপুট ত্রুটির 82% জন্য মান শব্দটি দায়ী। দ্বিতীয়ত, পণ্যগুলির মধ্যে সফটম্যাক্স এখনও FP32 এ কাজ করে। B200 এবং H200-এ, একই সূচক এবং এর FP8 কাস্ট দীর্ঘতম টিউব পর্যায়ে পরিণত হয়।
V-মসৃণ: মান বহির্মুখী সংশোধন করা
কিছু টোকেনে ভ্যালু আউটলায়ার পাওয়া যায় এবং তাদের চ্যানেলগুলি হেড, টিয়ার এবং টিয়ার জুড়ে চলে। demard এর একটি ঘূর্ণন প্রতীকী নিয়ম সংরক্ষণ করে, তাই এটি তাদের অপসারণ করে না। V ঘূর্ণন মান ত্রুটি মাত্র 0.2% পরিবর্তন করে।
ভি-মসৃণ একটি ভিন্ন রুট নেয়:
- গ্রুপ: অনলাইন k- মানে প্রতিটি ব্যাচ এবং মাথার জন্য ক্লাস্টার টোকেন মান। কী এবং মান একসাথে পরিবর্তিত হয়, তাই অ-কারণগত মনোযোগী আউটপুট পরিবর্তন হয় না।
- অপমান করা: 128 টোকেনের প্রতিটি হার্ডওয়্যার ব্লক তার গড় হ্রাস করে। প্রতি চ্যানেলে 8 বিটে E4M3 ব্যবহার করে বা 4 বিটে NVFP4 ব্যবহার করে শুধুমাত্র অবশিষ্টাংশ পরিমাপ করা হয়।
- পুনরুদ্ধার: অনলাইন সফ্টম্যাক্স ইতিমধ্যে সংরক্ষণ করে রাখা সারি যোগফল ব্যবহার করে গড় আবার যোগ করা হয়। একটি দ্বিতীয় পাস বা একটি অতিরিক্ত বাফার জন্য কোন প্রয়োজন নেই.
100 টির বেশি Wan2.2 হেডের গড়, ব্লক গড় ক্রমিক ক্রমে ব্লক শক্তির 8% সরিয়ে দেয়। এটি DeltaQuant স্ট্যাটিক কিউবের অধীনে 12% এবং সাজানোর পরে 36% সরিয়ে দেয়। প্রতিটি গড় মূল্য উপাদান প্রতি 0.125 বিট খরচ.
ক্লাস্টারিং শুধুমাত্র প্রথম 25% ডিনোইসিং ধাপে কাজ করে। বিনিময়ে, এটি 4টি সংলগ্ন পর্যায়ে পুনরায় ব্যবহার করা হয়। পুরো সময়সূচীতে গড়ে, কিবুটজ শোনার সময়ের 3 থেকে 4% খরচ করে।
ExpCast-FP8: Softmax বাধা অপসারণ
E4M3 বাইট ইতিমধ্যেই এটি সঞ্চয় করা মানের লগারিদমের কাছাকাছি। একটি পূর্ণসংখ্যা হিসাবে পড়ুন, এটি মোটামুটি 8 log2(v) + 56 এর সমান। তাই ExpCast-FP8 লগ ডোমেন স্কোর থেকে সরাসরি 1টি সংযুক্ত সন্নিবেশ সহ বাইটগুলি লেখে। ধ্রুবক β = -0.35 অবশিষ্ট ত্রুটিকে কেন্দ্র করে, এবং প্রতিটি মডেলের জন্য কোন ধ্রুবক সামঞ্জস্য করা হয় না।
প্রত্যক্ষ পাথ সূচকের পাথের মতো একই বাইট লেখে—তারপর প্রতিটি গুণের 79.6%-এ FP32 ওভারলে। অন্য কোথাও এটি এক কোড দূরে ল্যান্ড করে। কাগজটি 3.64% এর নিচে প্রয়োজনীয় রেখায় মোট বৈচিত্র্য প্রমাণ করে, প্লাস যেকোন প্রবাহ লেজ। মনোযোগের 204.8K Wan2.2 লাইন জুড়ে, মাপা গড় হল 1.6%। ExpCast-FP8 শুধুমাত্র 8-বিট কোরের ক্ষেত্রে প্রযোজ্য, কারণ NVFP4-এর কোনো একক ইনপুট-টু-কোড সম্পর্কিত মানচিত্র নেই।
প্রিপ্রসেসিং চেইনের হাতে লেখা CuTe/CUDA ফিউশন B200-এ 42.2ms থেকে 4.8ms পর্যন্ত একটি একক V-মসৃণ রিড কাটে।
